Steg 1 / 5

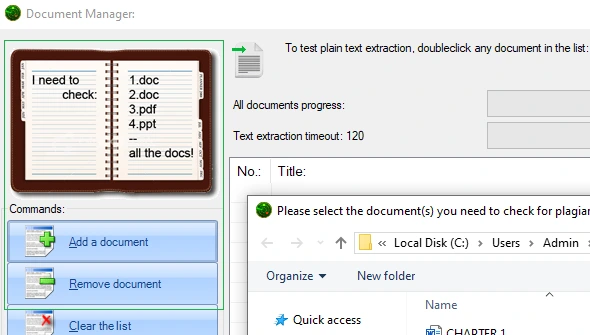
Detta exakta fönster gör det möjligt att lägga till och ta bort dokument för att senare kontrolleras för plagiat. Denna funktion inkluderar också ett testverktyg för textextraktion och några ytterligare TE-inställningar

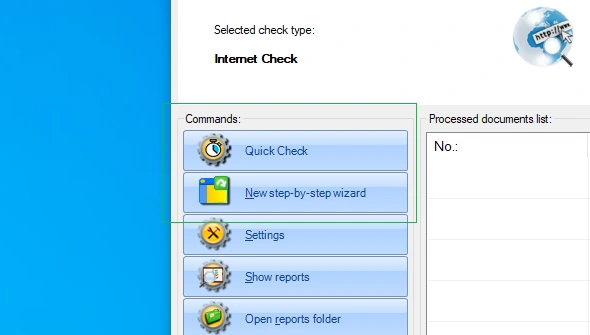
Plagiatdetektor har två bekväma utgångspunkter: den första - för att snabbt kontrollera med standardinställningar och den andra - en detaljerad steg-för-steg-guide med förklaringar och tips
Tre guidade steg - lägg till dina dokument, välj vad som ska upptäckas, välj kontrolltyp - och kontrollen startar. Den kan öppnas vid varje uppstart.
Välj en mapp, så kontrolleras varje dokument som kopieras in i den automatiskt med den analystyp du valde.
En Plagiarism Detector-flik i Office-menyfliksområdet: kontrollera det öppna dokumentet med ett klick.
'Kör plagiatkontroll' i Utforskarens meny i Windows för alla filer som stöds.
Steg 2 / 5

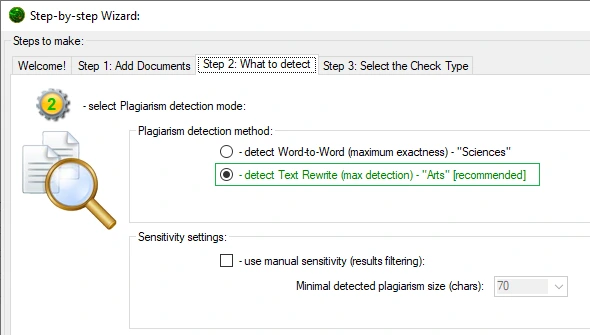
Denna förinställning för textjämförelse möjliggör en "slapp matchning" - det är idealiskt att leta efter en misstänkt textomskrivning. Den här förinställningen fungerar bäst för både "Arts"-texter och dokument

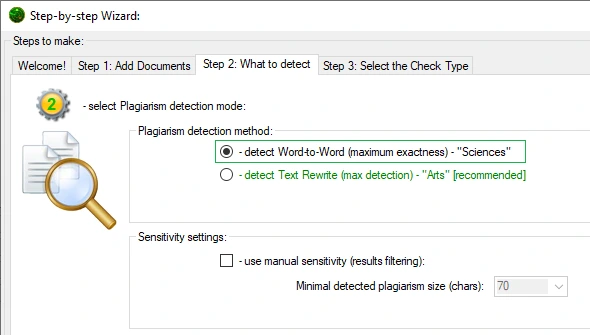
Det kallas också för "exakta vetenskaper" - det tillåter Plagiat Detector Text Comparison Engine att exakt matcha källan med misstänkta kopior, vilket minimerar falska positiva

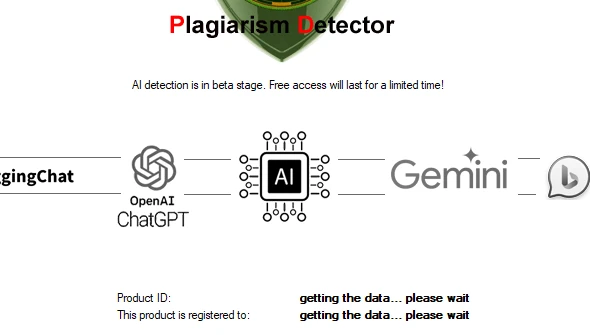
Plagiat Detector har nyligen lagt till vår senaste utveckling - en AI-detektionsmotor som gör det möjligt att upptäcka ett antal AI:er: Chat GPT, Google Gemini, Hugging Chat och Bing Bard

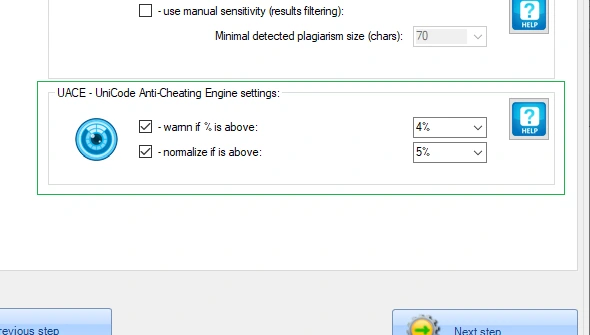
UACE - står för 'Unicode Anti-Cheating Engine'. Den här modulen gör analyser för att upptäcka den vanligaste fuskstrategin som ersätter Unicode-symboler med "lika" alternativ
Citerad text och URL-referenser identifieras och rapporteras separat, så korrekt citerad text räknas inte som plagiat.
Ställ in den minsta längden för plagiatavsnitt, sammanslagningsavståndet och ditt eget varningströskelvärde i %.
Språket i varje dokument identifieras automatiskt.
Steg 3 / 5

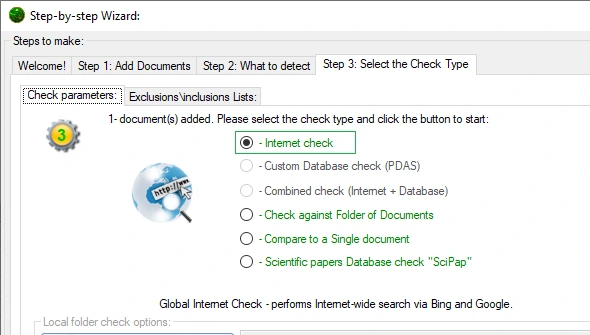
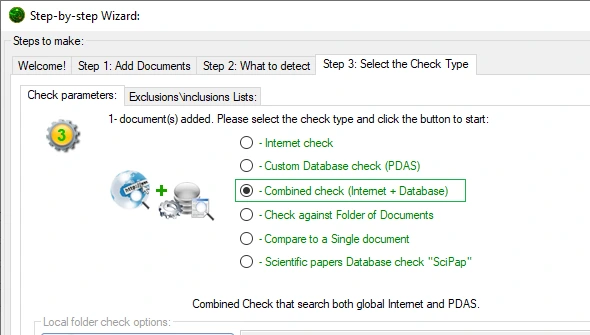
Detta är en standardsökning med störst omfattning efter plagiat på world wide web. Plagiat Detector använder Google, Bing och Yahoo som sina globala sökresultatleverantörer. Över 4 miljarder källor söks efter kopior!

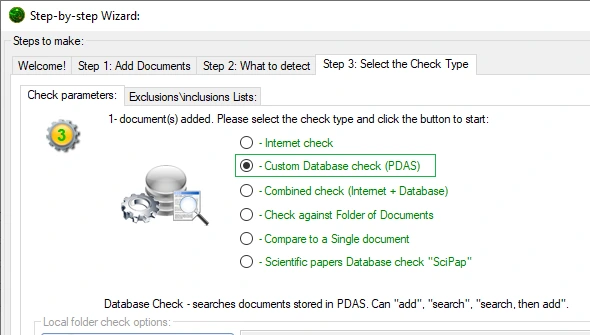
Plagiat Detector Accumulator Server - din egen databas med dokument för att köra plagiatkontroller. Du kan enkelt lägga till eller ta bort dokument från denna databas. Den fungerar som en LAN-åtkomstserver med flera klienter

Detta omfattar båda tidigare sökomfång - den här inställningen tillåter Plagiat Detector att kontrollera alla tillhandahållna källor - globalt internet och din anpassade databas. Detta är den mest kompletta plagiatsökningen

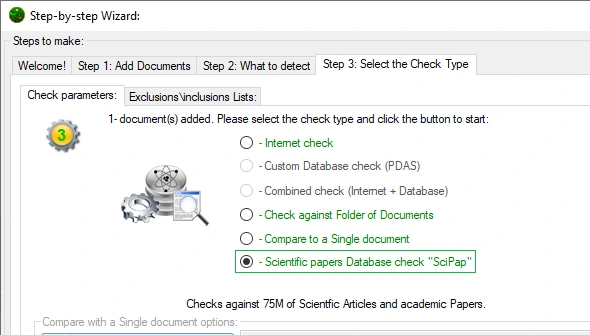
SciPap - står för 'Scientific Papers Database', exakt denna databas sammanställdes av din webbkrypande skördare - en analytisk sökmotor som genomsöker Internet för vetenskapliga artiklar

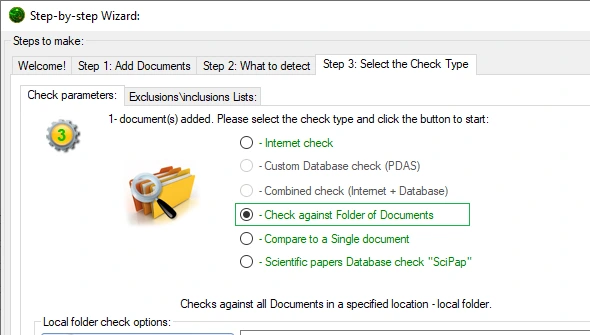
Detta gör det möjligt att köra en plagiatkontroll mot en mapp med dokument. Detta kräver ingen tidigare indexering, men är betydligt långsammare än PDAS-databaskontroller

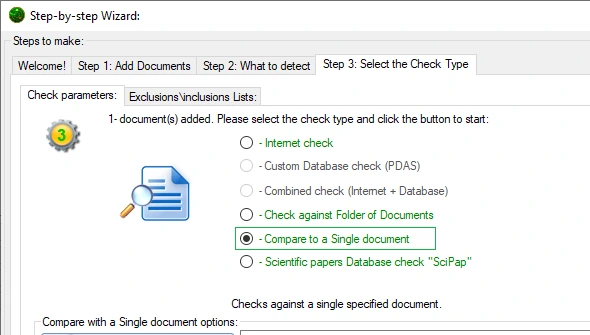
Detta gör att du kan köra en kontroll på ett par dokument. Du väljer bara källdokumentet och använder sedan detta exakta alternativ för att välja det andra dokumentet. Detta är en parvis kontroll

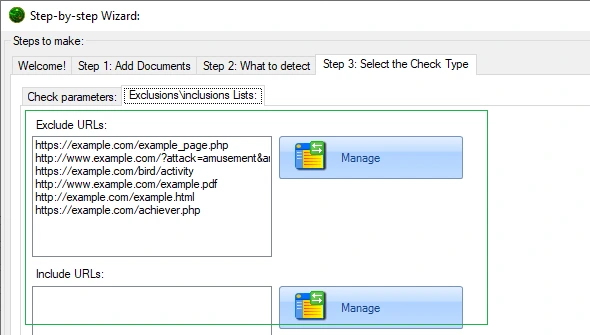
Ibland behöver du undvika att kontrollera mot en specifik resurs i ett dokument för att undvika falska positiva resultat eller göra precis tvärtom - för att tvinga Plagiat Detector att kontrollera en specifik sida
Inget internet? Kontrollera mot din egen PDAS-server på det lokala nätverket; den identifieras automatiskt.
Steg 4 / 5

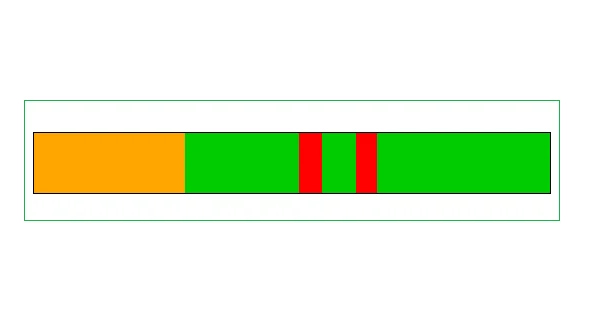
Denna färgglada stapel visar alla upptäckta och markerade delar av dokumentet på ett horisontellt eller vertikalt sätt - vilket ger en bild av platsen för de upptäckta underdelarna

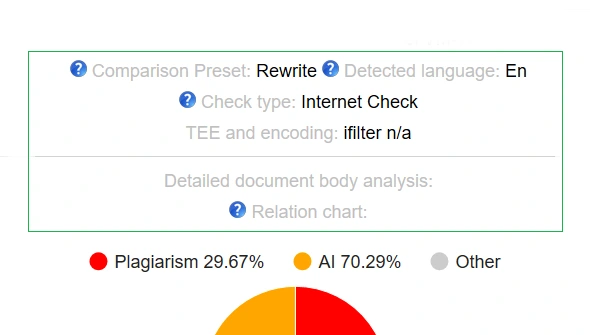
Varje originalitetsrapport har en rubrik som innehåller den viktigaste informationen om varje kontrollerat dokument. Det är ganska okomplicerat och enkelt nyckel-värde informationsblock

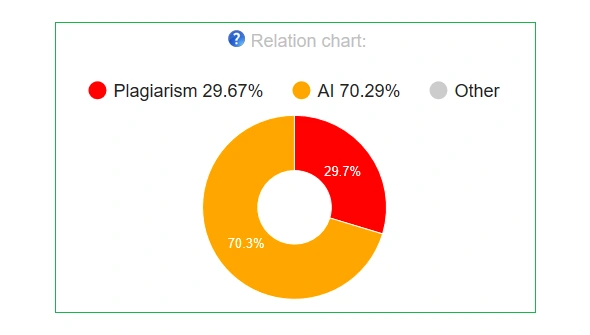
I alla genererade originalitetsrapporter kan du hitta ett cirkeldiagram för originalitetsrapportrelationer som tydligt visar skillnaden mellan AI-genererade, plagierade, original och citerade delar
Ditt textstycke och det matchande källstycket sida vid sida, avsnitt för avsnitt, med liknande ord, tecken och likhet i % för varje avsnitt.
En jämförelse på ordnivå av två matchande avsnitt: varje skillnad numrerad, med alternativ för att ignorera skiftläge och skiljetecken.
CS1 - text som matchas i fragment om 5+ ord, CS2 - i fragment om 25+ ord, CIT - text markerad som citerad eller refererad.
Ett rapportblock som flaggar träffar från Wikipedia, Google Books och kända spökskrivartjänster.
Steg 5 / 5

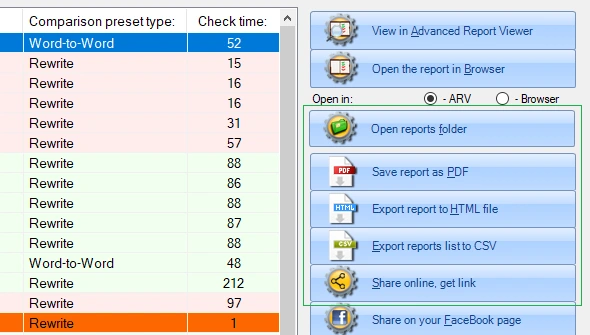
Ibland kan du behöva exportera en originalitetsrapport till ett mer bekvämt format - PDF\CSV\HTML etc. Detta är bara funktionen att använda! En sammanfattande rapport kan också skapas

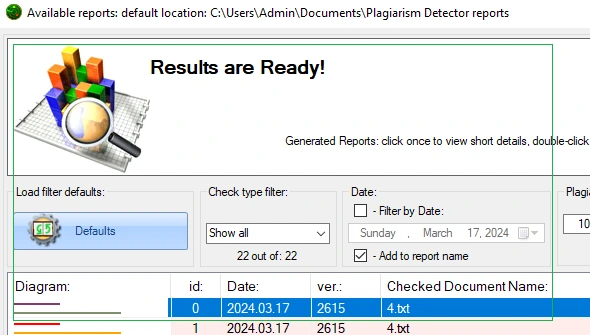
Inbyggd Originality Report Manager möjliggör enkel navigering, visning, filtrering, bedömning och manipulering av de genererade originalitetsrapporterna. Säkerhetskopiering och onlinedelning
Ladda upp en rapport och få en privat länk som vem som helst som har den kan öppna; den delade kopian raderas automatiskt efter 24 timmar.