단계 1 / 5

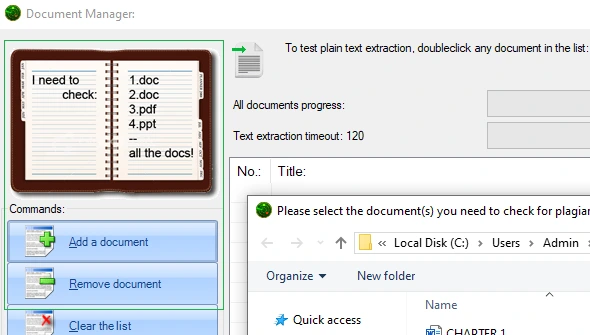
이 정확한 창에서는 나중에 표절 여부를 확인할 문서를 추가하고 제거할 수 있습니다. 이 기능에는 텍스트 추출 테스트 도구와 일부 추가 TE 설정도 포함되어 있습니다.

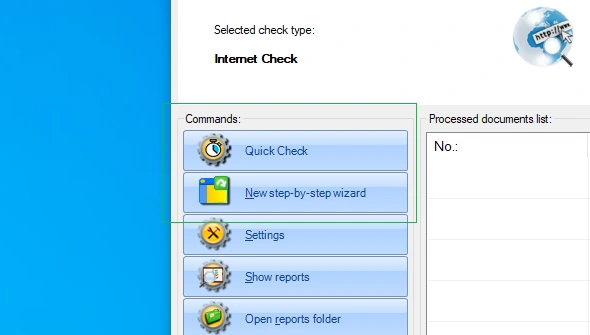
Plagiarism Detector에는 두 가지 편리한 시작점이 있습니다. 첫 번째는 기본값을 사용하여 빠르게 확인하고 두 번째는 설명과 힌트가 포함된 자세한 단계별 마법사입니다.
문서 추가, 탐지 대상 선택, 검사 유형 선택이라는 세 가지 안내 단계를 거치면 검사가 시작됩니다. 시작할 때마다 열리도록 설정할 수 있습니다.
폴더를 선택하면 그 안에 복사된 모든 문서가 선택한 분석 유형으로 자동 검사됩니다.
Office 리본의 Plagiarism Detector 탭: 클릭 한 번으로 열려 있는 문서를 검사합니다.
지원되는 모든 파일의 Windows Explorer 메뉴에 있는 '표절 검사 실행'.
단계 2 / 5

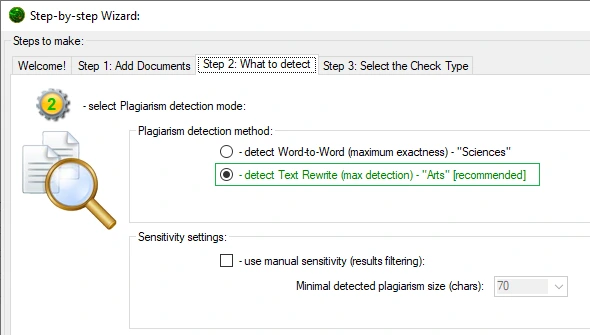
이 텍스트 비교 사전 설정은 '느슨한 일치'를 허용합니다. 이는 의심되는 텍스트 재작성을 확인하는 데 이상적입니다. 이 사전 설정은 '예술' 텍스트와 문서 모두에 가장 적합합니다.

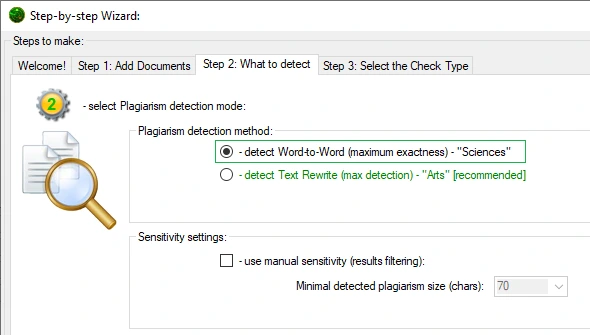
이는 '정확한 과학' 사전 설정이라고도 합니다. 이를 통해 표절 탐지기 텍스트 비교 엔진이 소스를 의심되는 사본과 정확하게 일치시켜 오탐을 최소화할 수 있습니다.

Plagiarism Detector는 최근 Chat GPT, Google Gemini, Hugging Chat 및 Bing Bard와 같은 다양한 AI를 감지할 수 있는 AI 감지 엔진이라는 최신 개발을 추가했습니다.

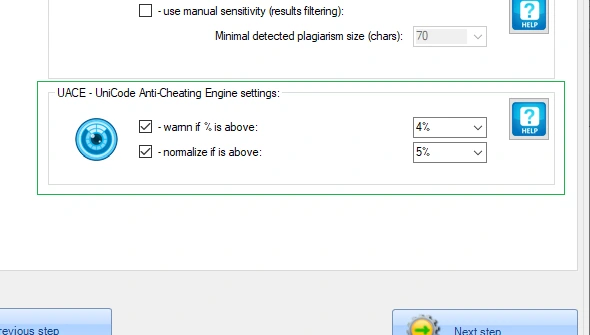
UACE - '유니코드 부정행위 방지 엔진'을 나타냅니다. 이 모듈은 유니코드 기호를 '유사한' 대안으로 대체하는 가장 일반적으로 사용되는 부정 행위 전략을 탐지하기 위한 분석을 수행합니다.
인용된 텍스트와 URL 참조는 별도로 인식되고 보고되므로, 올바르게 인용된 텍스트는 표절로 집계되지 않습니다.
최소 표절 구간 길이, 병합 거리, 자신만의 경고 임계값 %를 설정하세요.
모든 문서의 언어가 자동으로 감지됩니다.
단계 3 / 5

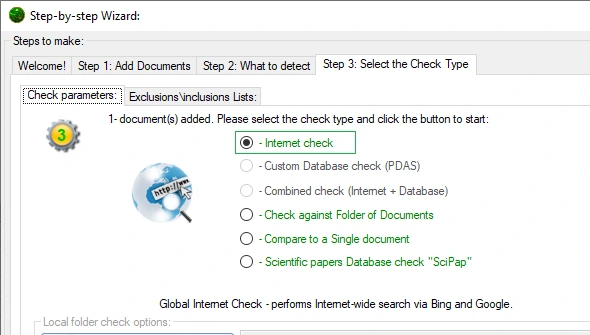
이것은 월드 와이드 웹에서 표절에 대한 표준 최대 범위 검색입니다. Plagiarism Detector는 Google, Bing 및 Yahoo를 글로벌 검색 결과 제공업체로 사용합니다. 40억 개가 넘는 소스에서 사본이 검색됩니다!

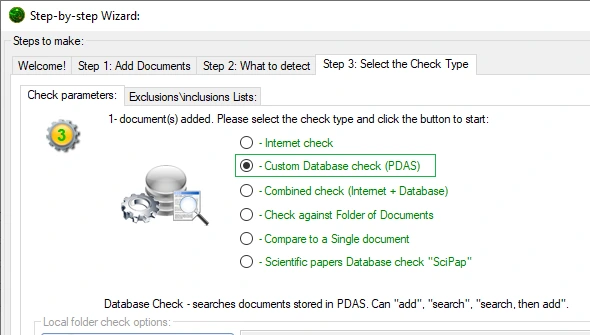
표절 탐지기 누산기 서버 - 표절 검사를 실행하기 위한 자체 문서 데이터베이스입니다. 이 데이터베이스에서 문서를 쉽게 추가하거나 제거할 수 있습니다. 여러 클라이언트가 있는 LAN 액세스 서버로 작동합니다.

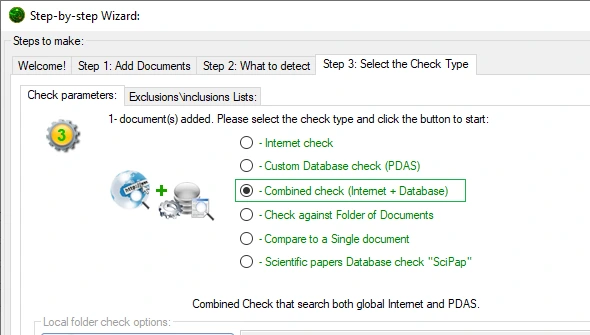
이는 이전 검색 범위로 구성됩니다. 이 설정을 사용하면 표절 탐지기가 제공된 모든 소스(글로벌 인터넷 및 사용자 정의 데이터베이스)를 확인할 수 있습니다. 이것은 가장 완벽한 표절 검색입니다

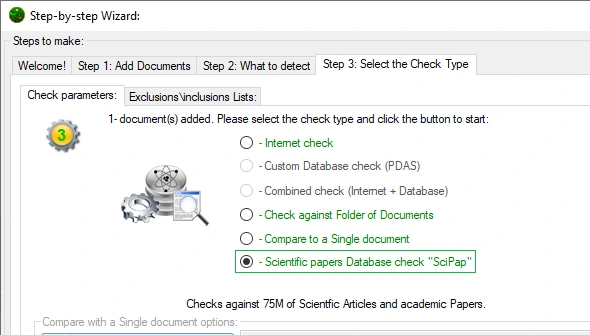
SciPap - '과학 논문 데이터베이스'를 의미하며, 이 정확한 데이터베이스는 과학 논문을 위해 인터넷을 크롤링하는 분석 검색 엔진인 웹 크롤링 수집기에 의해 컴파일되었습니다.

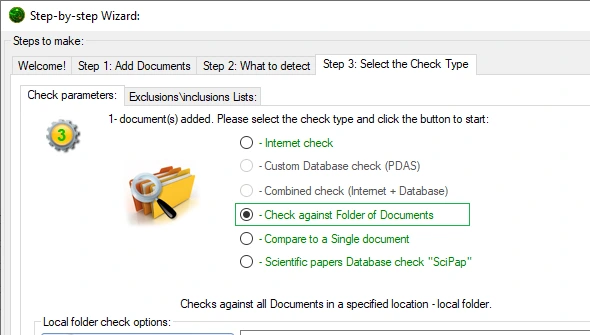
이를 통해 문서 폴더에 대해 표절 검사를 실행할 수 있습니다. 이전 인덱싱이 필요하지 않지만 PDAS 데이터베이스 검사보다 속도가 상당히 느립니다.

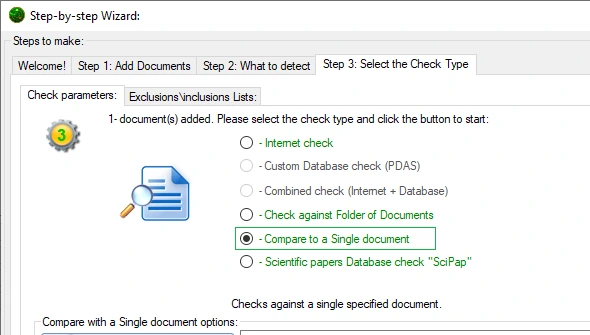
이를 통해 한 쌍의 문서에 대해 확인을 실행할 수 있습니다. 소스 문서를 선택한 다음 바로 이 옵션을 사용하여 다른 문서를 선택하면 됩니다. 이는 쌍별 검사입니다.

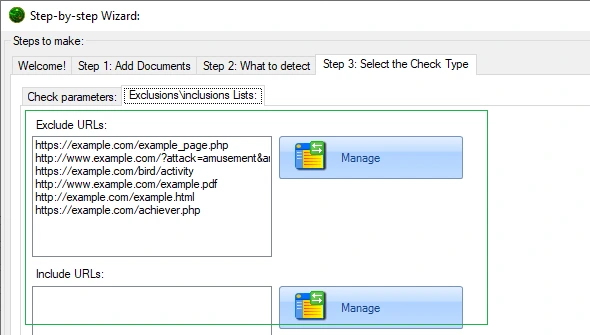
때때로 잘못된 긍정 결과를 피하기 위해 문서의 특정 리소스에 대한 확인을 피하거나 그 반대의 작업을 수행해야 하는 경우가 있습니다. 즉, 표절 탐지기가 특정 페이지를 확인하도록 강제하는 것입니다.
인터넷이 없나요? 로컬 네트워크의 자체 PDAS 서버를 통해 검사할 수 있으며, 자동으로 감지됩니다.
단계 4 / 5

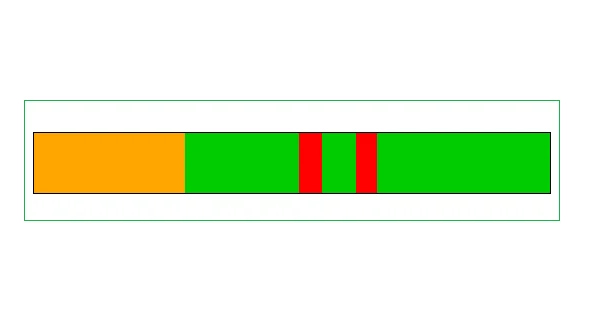
이 다채로운 막대는 문서에서 감지되고 표시된 모든 부분을 수평 또는 수직 방식으로 표시하므로 감지된 하위 부분의 위치를 볼 수 있습니다.

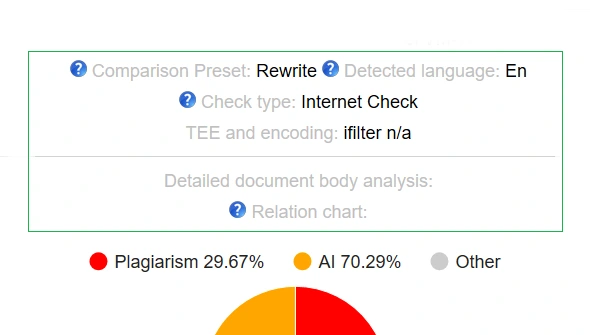
모든 독창성 보고서에는 확인된 각 문서에 대한 가장 중요한 정보가 포함된 헤더가 있습니다. 매우 간단하고 간단한 키-값 정보 블록입니다.

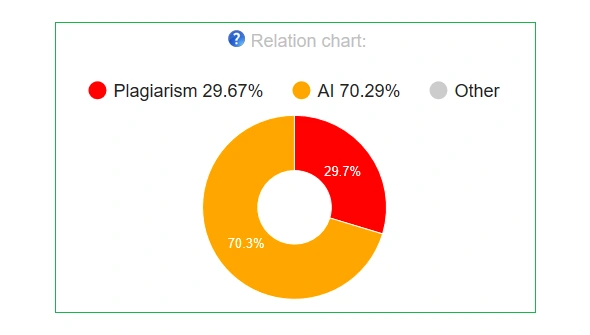
생성된 독창성 보고서에서는 AI 생성, 표절, 원본 및 인용 부분 간의 차이를 명확하게 보여주는 '독창성 보고서 관계 원형 차트'를 찾을 수 있습니다.
사용자의 구절과 일치된 원본 구절을 구간별로 나란히 비교하며, 각 구간마다 유사한 단어, 문자, 유사도 %를 보여줍니다.
일치된 두 구간의 단어 단위 비교: 모든 차이에 번호가 매겨지며, 대소문자와 구두점을 무시하는 옵션도 있습니다.
CS1 - 5단어 이상 구간에서 일치된 텍스트, CS2 - 25단어 이상 구간에서 일치된 텍스트, CIT - 인용 또는 출처 표시된 텍스트.
Wikipedia, Google Books 및 알려진 대필 서비스와의 일치를 표시하는 보고서 블록입니다.
단계 5 / 5

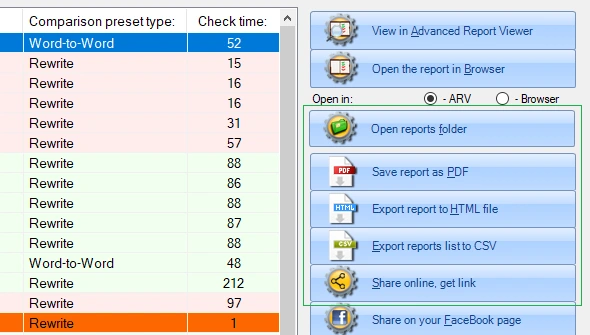
때로는 독창성 보고서를 보다 편리한 형식(PDF\CSV\HTML 등)으로 내보내야 할 수도 있습니다. 이는 바로 사용할 수 있는 기능입니다! 요약 보고서도 생성할 수 있습니다.

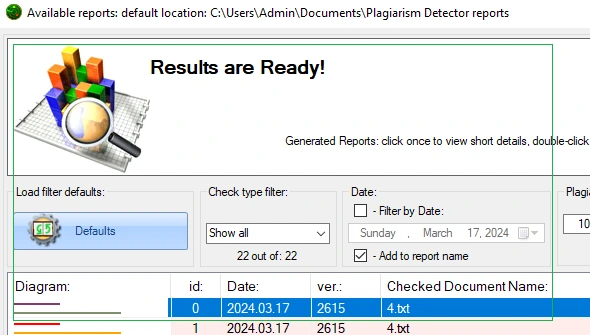
내장된 독창성 보고서 관리자를 사용하면 생성된 독창성 보고서를 쉽게 탐색, 보기, 필터링, 평가 및 조작할 수 있습니다. 백업 및 온라인 공유
보고서를 업로드하면 링크를 가진 누구나 열어볼 수 있는 비공개 링크가 생성되며, 공유된 사본은 24시간 후 자동으로 삭제됩니다.